DGX Spark を4台並べて、GLM-5.2 を vLLM でしばらくサーブした備忘録。
参考元: GLM-5.2-QuantTrio-TP4-DCP2-4x-DGX-Spark
ノード名は melchior / balthasar / casper / artaban 。
| 項目 | 値 |
|---|---|
| ハード | NVIDIA DGX Spark ×4(合計 800 W) |
| モデル | QuantTrio/GLM-5.2-Int4-Int8Mix(405 GB / 128 shards) |
| 並列度 | TP=4 / PP=1 / DCP=2(Ray不使用) |
| Attention backend | B12X_MLA_SPARSE |
| KV cache | fp8_ds_mla、323,712 tokens |
| コンテキスト | 163,840 / max seqs 6 |
| 投機デコード | MTP k=2(draft TP=4) |
| API | OpenAI互換 |
| 実測 decode | 19.7 tok/s(実トラフィック下) |
ネットワーク
DGX Spark には、
- RJ-45(管理用)
- ConnectX-7 の QSFP ×2(200 GbE 表記)
があるが、管理 / HTTPアクセス用とNCCLレーンを分離した。
| 用途 | 経路 |
|---|---|
| SSH / 管理 | RJ-45 |
| NCCL 転送 | f1 レール 10.42.0.1-4(MTU 9000) |
RAILIPS / IFNAME / HCA に 管理系 の IP を入れてはいけない。 起動はするが NCCL がとんでもなく遅い経路を掴んで低速サーブになる。
ConnectX-7
あちこちで言及されているが、癖がある。 100GbEのモジュール を使った2ノードでの実測は次の通り。
| NCCL all-reduce構成 | 直結 |
|---|---|
| TCP socket (NCCL_NET=Socket) | 2.03GB/s |
| RoCE 1レーン (rocep1s0f0) | 12.12GB/s |
| RoCE 2レーン (rocep1s0f0,roceP2p1s0f0) | 11.89GB/s |
| RoCE 4レーン | 21.81GB/s ≒ 174 Gb/s |
ConnectX-7だが、Infinibandは非対応。
ib_write_bw を使うと、2ポート線速が出る。単位が混ざってるのは許して。
| NCCL all-reduce構成 | 直結 |
|---|---|
| 全ペア片方向 f0レーン | 98.01Gb/s |
| 4QP並列 | 49.01Gb/s x4本 = 196Gb/s |
基本の設定
MTU=9000
NCCL_NET_PLUGIN=none
NCCL_IB_MERGE_NICS=1
NCCL_IB_HCA=rocep1s0f0,roceP2p1s0f0,rocep1s0f1,roceP2p1s0f1
NCCL_IB_GID_INDEX=3
ノードの準備
- DGX OS:最新
- DGXのハードウェアドライバ:最新
- 闇が深い。古いドライバを使うと、FAN=2RPMで固定されててアチアチとか、最新にするとファンが死んでチップが焼けたとか色々ある。ご調査推奨。
- DockerとNVIDIA Container Toolkitのセットアップ
- モデルウェイトの配置
- 基本
melchiorでダウンロードし、rsyncで他ノードへコピー。NFSとか使っても良いかもね
- 基本
コンテナイメージ
イメージは vllm-dcp-glm52:e232d26 を使っている。
正直に書いておくと、melchior/balthasar と casper/artaban でイメージの中身が微妙に違う。ビルドし直した時期がずれた結果そうなった。
melchior, balthasar : vllm-dcp-glm52:e232d26 -> sha256:a43cce1c...
casper,   artaban   : vllm-dcp-glm52:e232d26 -> sha256:e65082a2...
普通なら揃えるべきだが、この構成で安定稼働している実績があるので、触らぬ神に祟りなし。
並列度の決め方(TP / PP / DCP)
ウチの環境の結論 : TP=4 / PP=1 / DCP=2。
Ray は不使用
vLLM のドキュメントには、マルチノードのランタイムとして Ray のほかに multiprocessing も使える旨が書かれている。
4台程度なら Ray クラスタを立てて ray start / ray stop を回すより、素の起動のほうが取り回しが良い。落ちたときの復旧も単純になる。
過去に Ray でやっていた頃、ログが “Loading…100%” で凍るという現象に何度も遭遇した。Ray をやめてvLLMネイティブにしたところ、解消した。
PP=1
GLM-5.2 は MLA 系のアーキテクチャで、PP を入れるとパイプラインバブルとメモリ配置の両方で損をする。TP=4 で全ノードに横一列に割ってしまうほうが素直だった。
DCP=2
DCP は tp_size を割り切れる必要があり、world size は増えない(TP グループの GPU を再利用する)。TP=4 なので DCP は 2 か 4。今回は 2 にしている。
DCP を切ると速いが、待ち時間が長くなった。
うちの環境ではコーディングエージェントの利用が9割で、UX維持のため DCP=2 を採用している。
| 構成 | KV 容量 | 実効 ctx | decode | キュー待ち発生率 |
|---|---|---|---|---|
| DCP=2 | 259,968〜278,272 | 163,840 | 24.74 tok/s | 4.45% |
| DCP off | 131,392 | 131,072 | 27.27 tok/s | 17.8% |
Attention backend と KV キャッシュ
B12X_MLA_SPARSE
backend は B12X_MLA_SPARSE を指定している。
このスパース構造に対応した backend でないと、そもそも性能が出ない。というより、stock の vLLM には GB10(sm_121)向けの sparse-MLA 実装が当時は無かった。
関連して --hf-overrides で index_topk_pattern を渡している。
fp8_ds_mla
KV cache dtype は fp8_ds_mla。
B12X_MLA_SPARSE が受け付けるのは auto / fp8 / fp8_ds_mla のみ。dtype 一覧に見える turboquant_* や nvfp4 は別の attention backend 用で、ここでは通らなかった。
KV容量
KV 容量は固定値ではなく、--max-num-batched-tokens で動く。
| BATCHTOK | KV 容量 |
|---|---|
| 2048 | 355,840 |
| 4096 | 323,712〜327,424 |
| 8192 | 259,968 |
バッチ用のワークスペースと KV が同じプールを食い合っているので、BATCHTOK を上げると KV が減る。試した結果、 4096 で利用することにした。
max-num-seqs 6 は少なく見えるが、BATCHTOK = 8192 の 259,968 tokens の KV を 163,840 の最大コンテキストで割ると、理論上そもそも1.5本しか同時に走らない。実際にはリクエストが常にフルコンテキストを使うわけではないので6本にしているが、これ以上増やすとプリエンプションが始まる。
GMU 0.89 も同じ理由。GB10 はドライバが約 12 GB 予約するので、総メモリ 121.7 GiB に対して GPU から使えるのは実質 107 GiB 前後。405 GB / 512 GB という余白の薄さでは、0.9 を超えると OOM で落ち、0.85 まで下げると KV が足りなくなる。0.89 は試行錯誤の結果で得た。
最終的にはこんな感じの設定に落ち着いた。
| パラメータ | 値 |
|---|---|
--max-model-len | 163,840 |
--max-num-seqs | 6 |
--max-num-batched-tokens | 4,096 |
--gpu-memory-utilization | 0.89 |
MTP(Multi-Token Prediction)
投機デコードとして MTP を使っている。
num_speculative_tokens= 2- draft 側も TP=4
効果は実測 tokens/step 2.54。k=2 なので理論上限は 3.0(本体1 + draft2)、そこに対して 2.54 なので、受理率はかなり良く、80%前後をキープ。
ただし、k を増やすほど通信律速がPrediction向上分を食っていく。試した組み合わせは次の通り。虫食いなのは許して
| 構成 | k=2 | k=4 | k=5 | k=6 |
|---|---|---|---|---|
| DCP2, batch4096, cg8 | 23.96 | 24.33 | — | 20.61 |
| DCP2, batch8192, cg64 | 24.74 | — | 21.08 | — |
| DCP off, batch8192, cg64 | 27.27 | — | 24.15 | — |
k=2 がどのスタックでも最適。k=4 は誤差の範囲、k≥5 は明確に悪化する。ステップ時間は概ね step ≒ base + 14·k [ms] で伸びるので、k を増やすほど1ステップが重くなり、受理率の向上分がなくなる。
起動
起動は自前スクリプトに環境変数を渡す方式にしている。
RAILIPS="10.42.0.1 10.42.0.2 10.42.0.3 10.42.0.4" \
IFNAME="enp1s0f1np1" \
HCA="rocep1s0f1,roceP2p1s0f1" \
DCP=2 \
MTPK=2 \
CTX=163840 \
SEQS=6 \
BATCHTOK=4096 \
CGMAX=64 \
GMU=0.89 \
  ./deploy/glm52-dcp-launch.sh up
各変数の意味。
| 変数 | 意味 |
|---|---|
RAILIPS | f1レールの全ノードIP |
IFNAME | NCCL に使わせるインターフェース名 |
HCA | RoCE デバイス(phys_port_name を確認して選ぶ) |
DCP | decode context parallel size |
MTPK | MTP の投機トークン数(0/1のトグルではない) |
CTX | max-model-len |
SEQS | max-num-seqs |
BATCHTOK | max-num-batched-tokens |
CGMAX | CUDA Graph の最大キャプチャサイズ(SEQS×(MTPK+1) 以上に) |
GMU | gpu-memory-utilization |
コンテナに渡している NCCL 環境変数。
NCCL_NET=IB
NCCL_IB_DISABLE=0
NCCL_IB_GID_INDEX=3
NCCL_IB_HCA=rocep1s0f1,roceP2p1s0f1
NCCL_IB_MERGE_NICS=1
NCCL_SOCKET_IFNAME=enp1s0f1np1
GLOO_SOCKET_IFNAME=enp1s0f1np1
NCCL_CROSS_NIC=1
NCCL_CUMEM_ENABLE=0
NCCL_NCHANNELS_PER_NET_PEER=4
NCCL_IB_QPS_PER_CONNECTION=4
NCCL_IGNORE_CPU_AFFINITY=1
docker run 側の引数。
--device /dev/infiniband:/dev/infiniband— これが無いと NCCL は黙って TCP ソケットにフォールバックするっぽい挙動なので、お守りとして。--ulimit nofile=1048576:1048576— 無いとノード間 NCCL がCall to socket failed: Too many open filesで落ちる。
監視
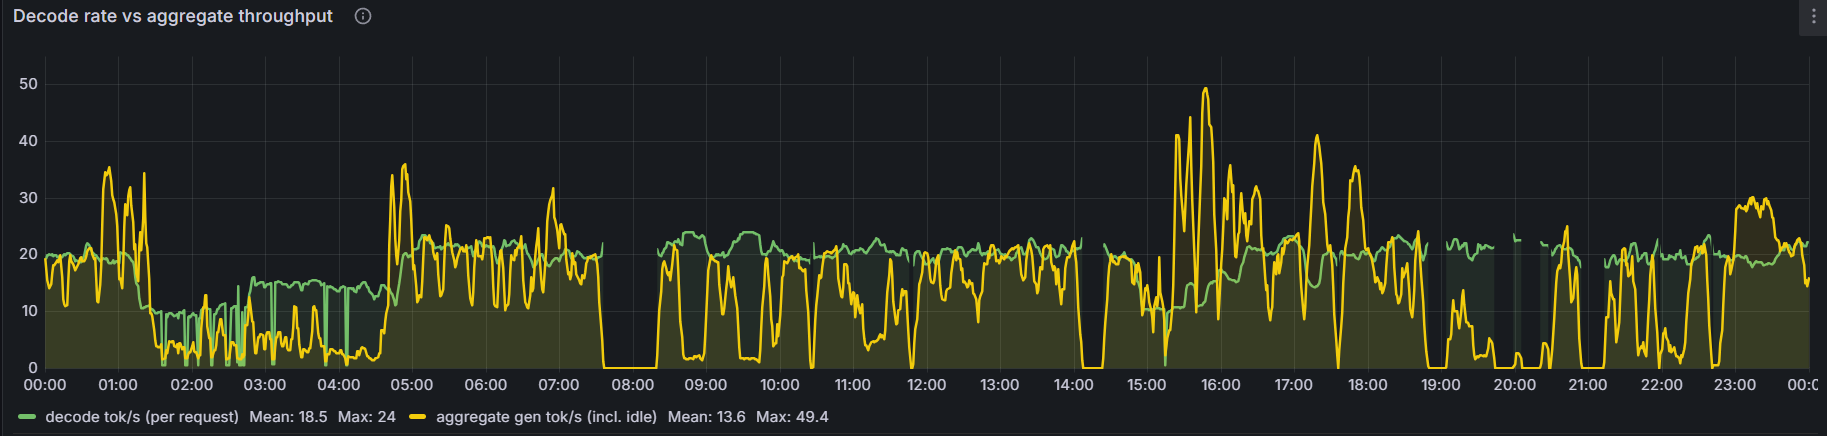
エンドユーザーに OTEL を入れてないので、 vLLM の Metric を Prometheus + Grafana で見る。 24時間の中央値(実トラフィック下・アイドル含む)だと次のような値だった。
| 指標 | 値 |
|---|---|
| decode | 20.0 tok/s(p90 で 21.6) |
| tokens/step | 2.51 |
| step 時間 | 125 ms |
| KV 使用率 | 中央値 6.6% / 24hピーク 75.4% |
| 待ちキュー | 0 |
| サーマルスロットリング | 0 |
隔離ベンチ(他のトラフィックなし、BATCHTOK=8192)では 24.74 tok/s。
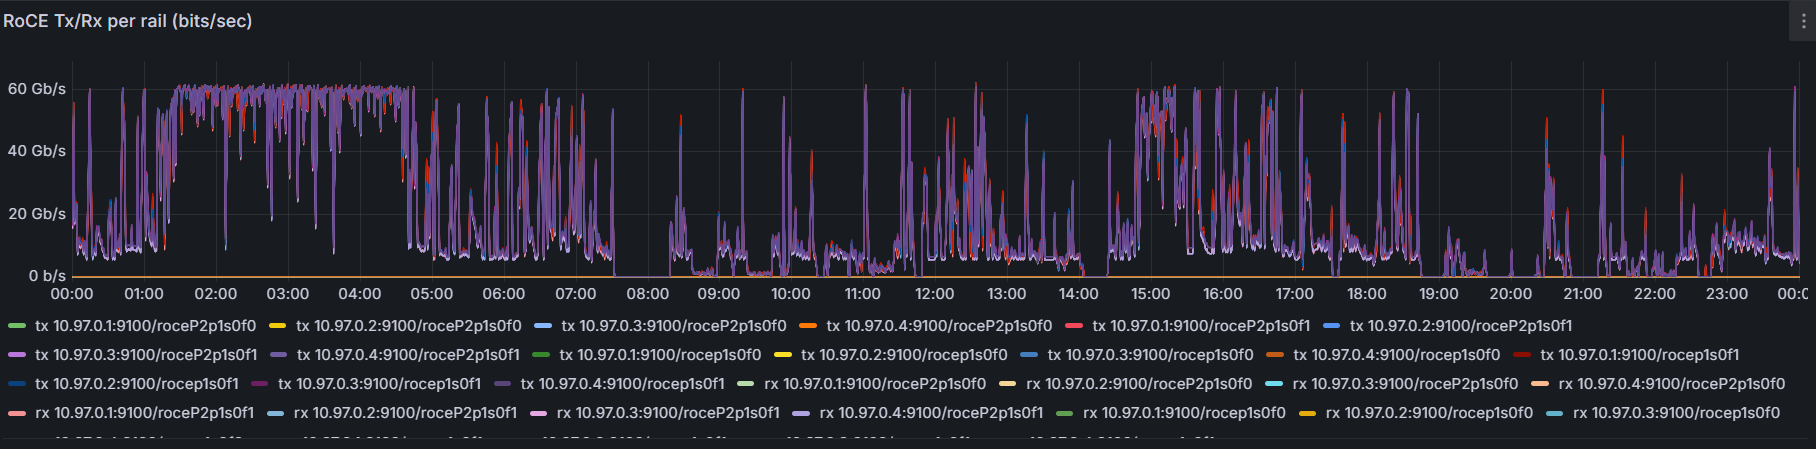
ネットワーク
現在は100GbE 1レールだけで運用している。実測では次の通り。実トラフィックでは別のところに律速がありそう。
Decode Rate / スループット / Prefix cache
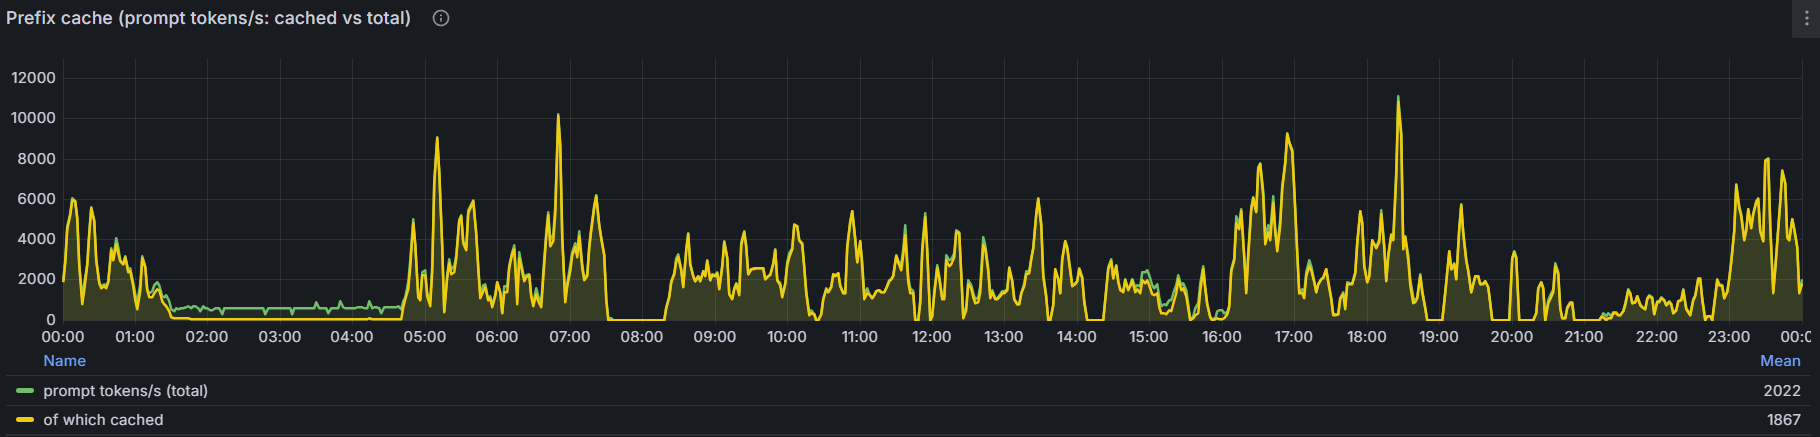
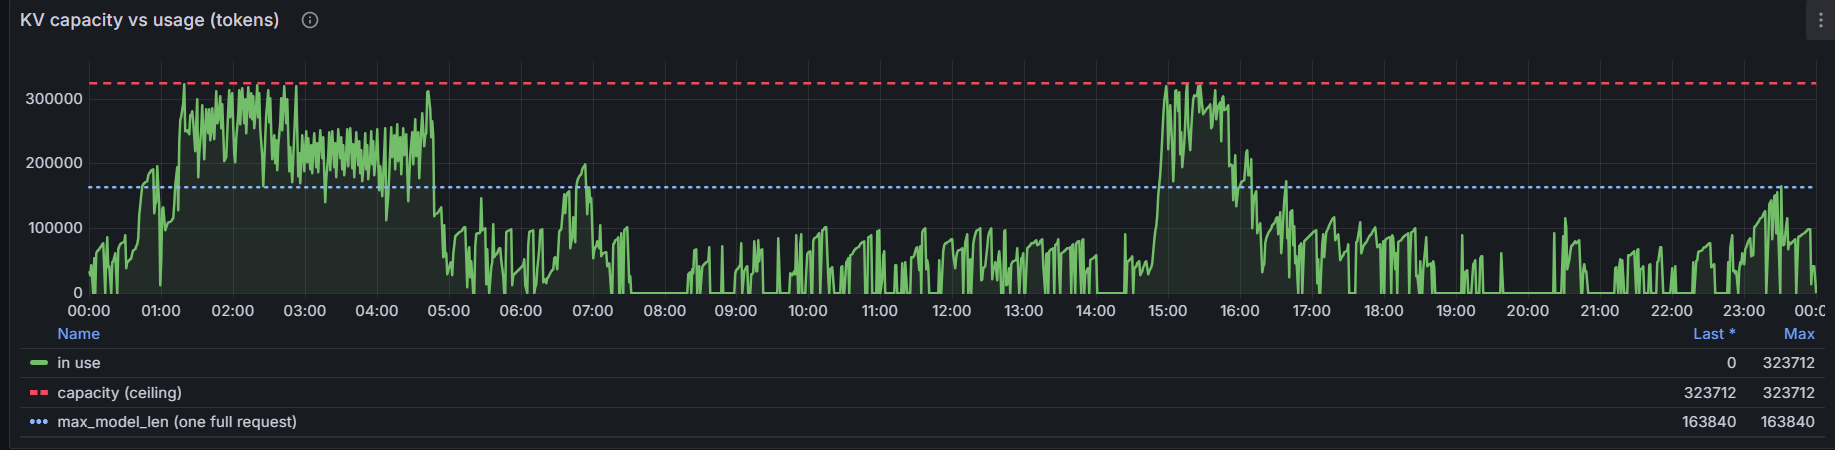
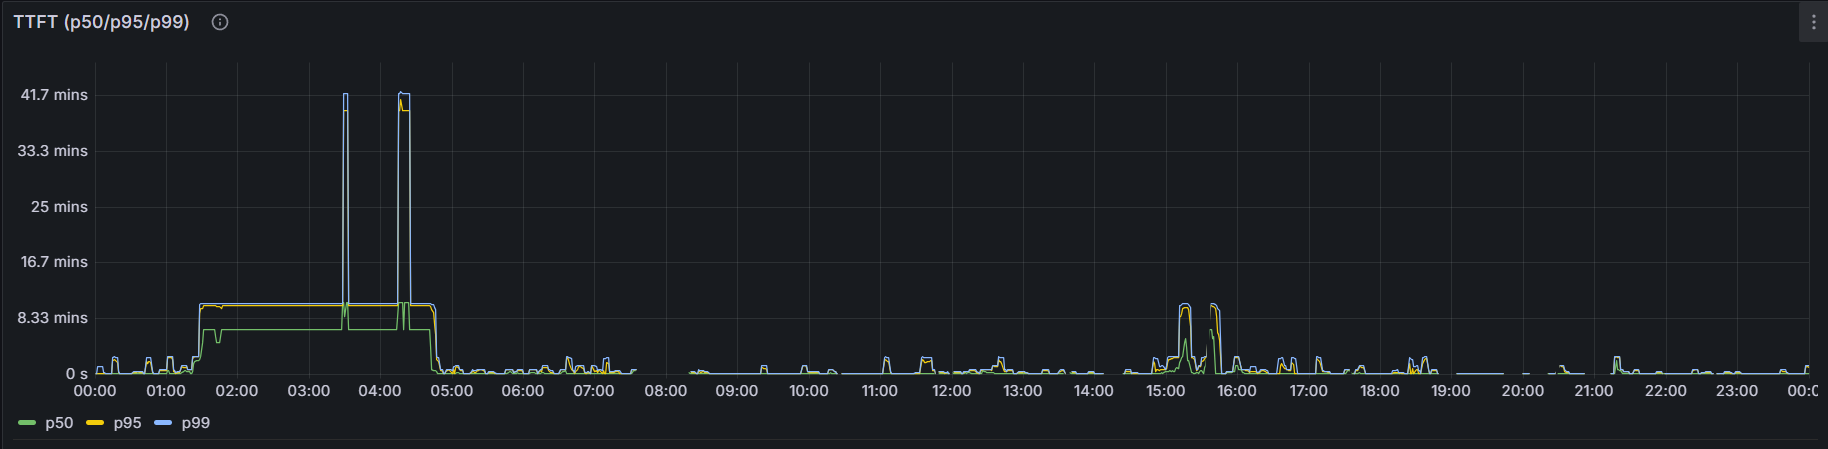 TTFT=40分とかなってますね……人間は寝てると思うので良いのですが……
消費電力
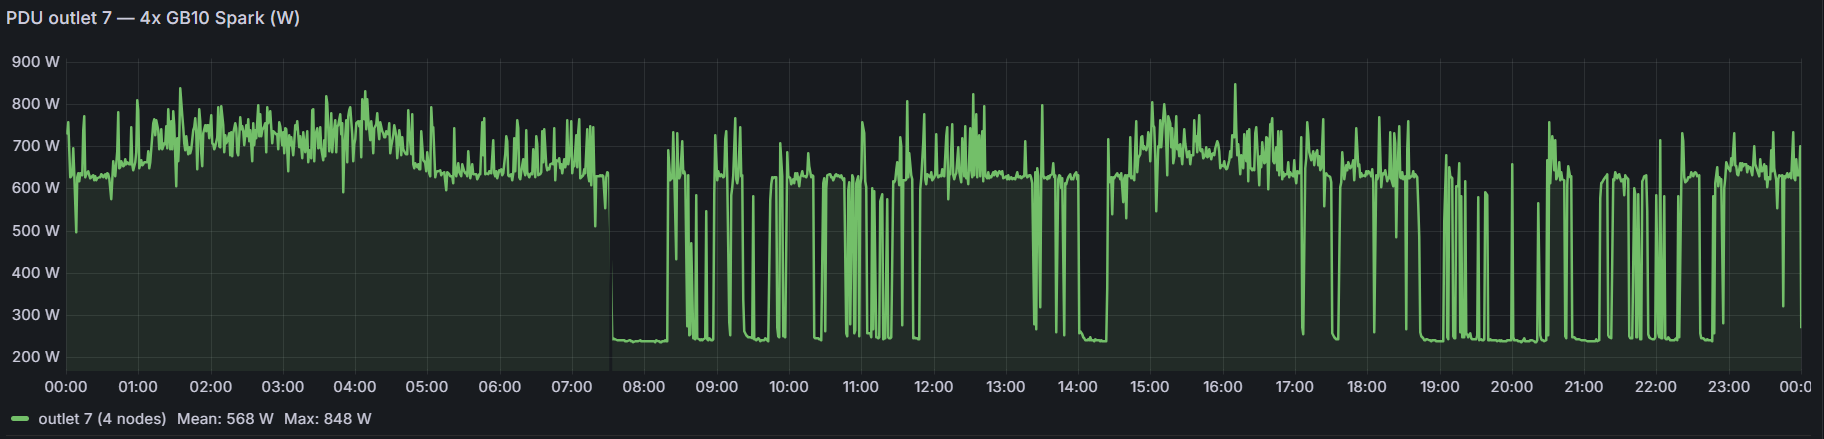
PDU読みの消費電力は4台合計で、7日間の実測が min 195 W / 平均 568 W / max 848 W。アイドルと全力で4倍以上ぶれるので、「◯◯W の機材」と一言で言えるものではなかった。
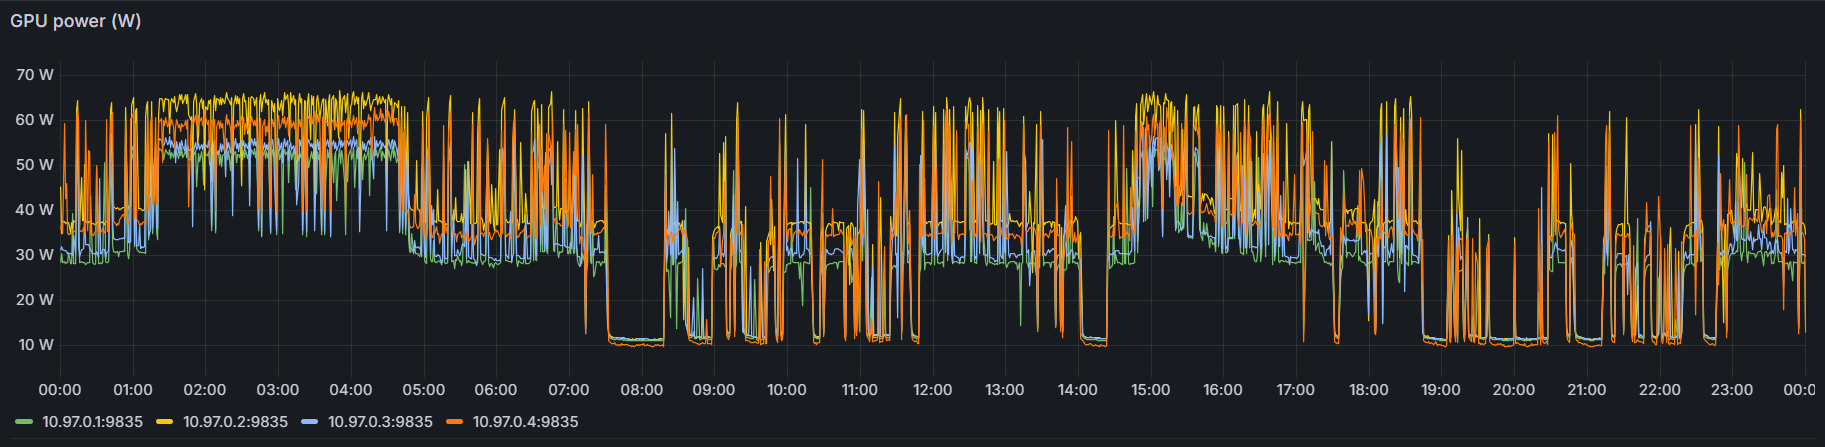
Nvidia-SMI読みの消費電力と、ACタップ点での4台合計の消費電力は次の通り。